<하네스 엔지니어링으로 완성하는 에이전틱 AI> 모델에게 부탁할 것과 코드로 강제할 것을 가르는 법

한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬 받아 작성된 서평입니다.
이 책을 고른 이유
올해 들어 하네스 엔지니어링이라는 말이 부쩍 자주 보인다. 그런데 막상 열어 보면 대부분 CLAUDE.md나 AGENTS.md를 어떻게 쓰느냐는 이야기였다. 프롬프트 엔지니어링이 이름만 바뀐 건지, 정말 다른 무엇인지 잘 구분이 안 됐다.
Claude Code를 쓰면서 CLAUDE.md에 적어둔 규칙도 꽤 된다. 모델이 그중 하나를 건너뛰면 할 수 있는 일은 문장을 더 세게 고쳐 쓰는 것 정도였다. 무엇을 글로 적어두고 무엇을 다른 방법으로 막아야 하는지는 따로 생각해 본 적이 없다.
이 책은 그 경계를 정면으로 다룬다. 2026년 초부터 온라인에서 말하는 하네스는 대부분 .md 파일에 높은 우선순위를 주는 기법이라고 정리하고(35쪽), 에이전트를 만드는 개발자가 다루는 하네스는 코드 레벨에서 만들어진다고 선을 긋는다(140쪽). 이름만 바뀐 건지 아닌지 이 책이면 답이 나올 것 같아서 골랐다.
이런 분에게 추천한다
- LLM API로 에이전트를 직접 만들어 보려는 주니어 개발자 (저자가 마치면서에서 독자를 이렇게 정한다)
- 데모까지는 됐는데 같은 질문에 다른 답, 끝없는 툴 호출, 불어나는 토큰 앞에서 멈춘 사람
- Claude Code나 Codex를 쓰면서
.md규칙과 코드 레벨 통제의 차이를 정리하고 싶은 사람
세 번째 경우라면 5.2절과 12장을 중심에 두고 읽으면 된다. 5.6절의 클로드 코드 설명은 공식 문서와 대조하면서 읽는 편이 안전하다(아쉬운 점에 이유를 적었다).
반대로 랭그래프나 RAG 자체를 깊게 파는 책을 기대한다면 이 책은 아니다. RAG, 멀티 에이전트, vLLM 서빙, Lambda 배포까지 14장 안에 다 들어 있어서, 각 주제는 실습으로 한 번 돌려보는 깊이에서 멈춘다.
읽어보니
프롬프트는 부탁하고, 하네스는 강제한다
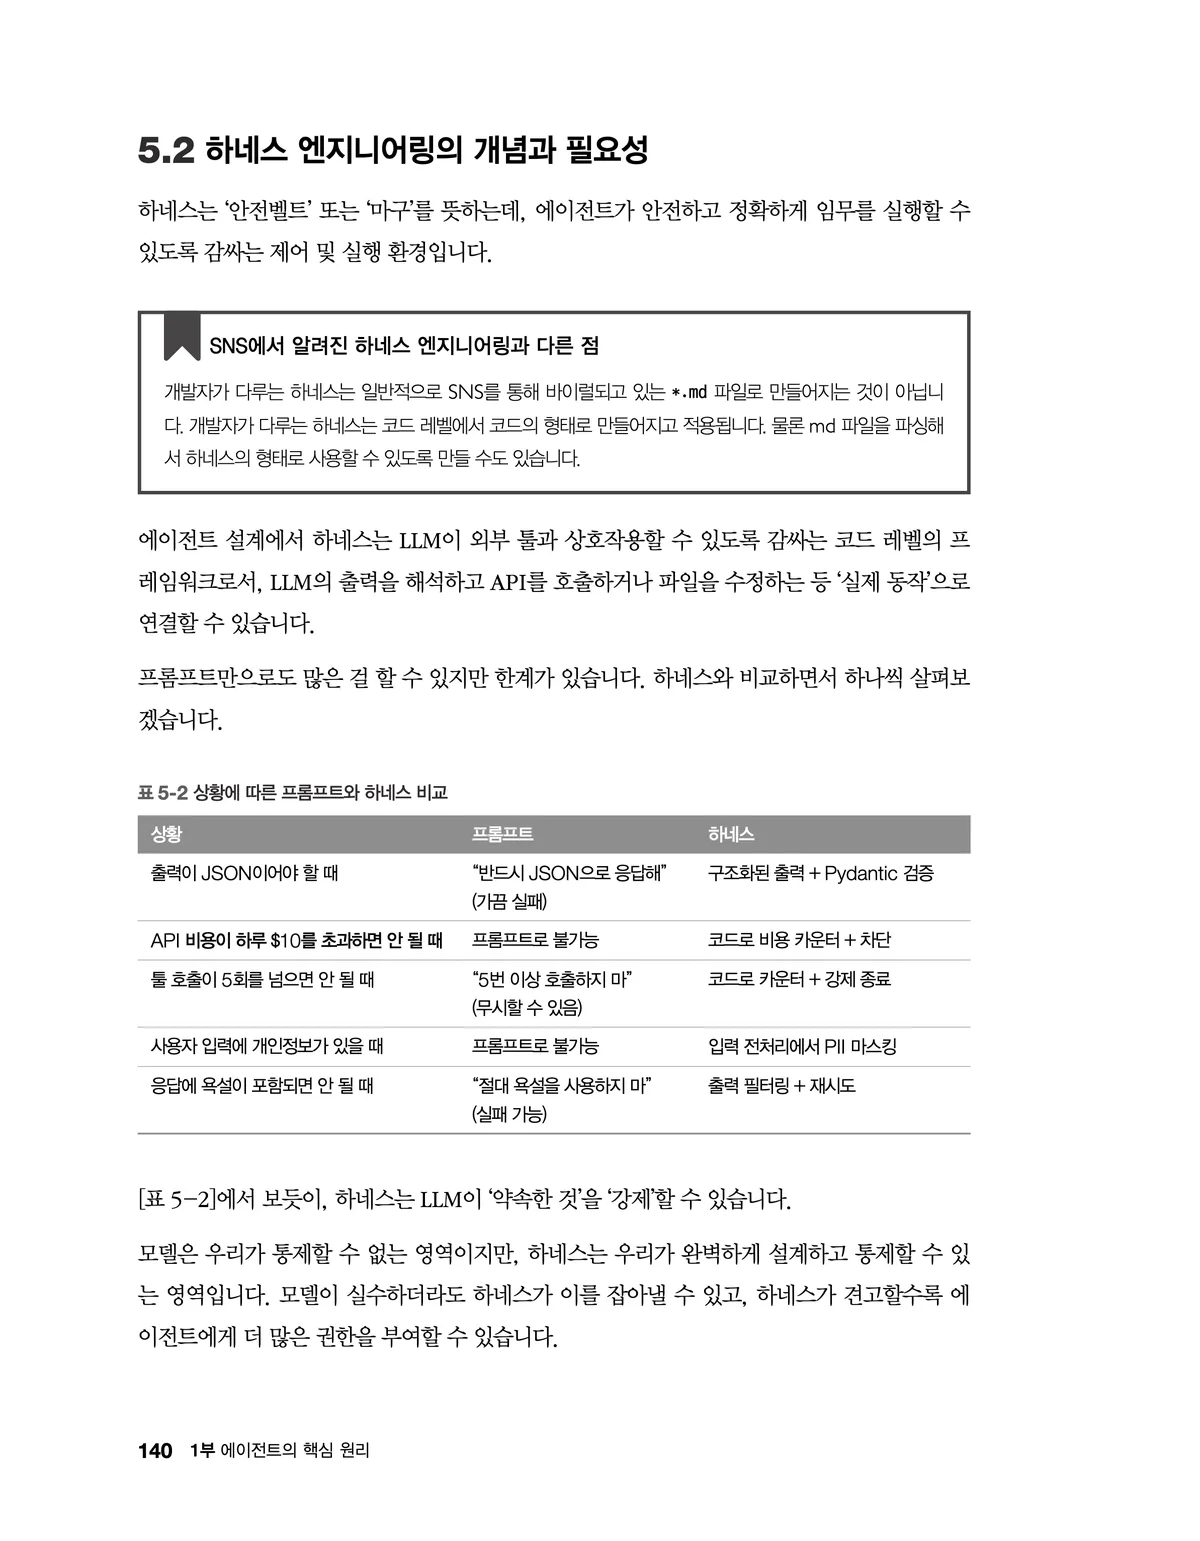
140쪽의 표가 책 전체를 요약한다. 출력이 JSON이어야 할 때 프롬프트는 JSON으로 답하라고 요구할 뿐이고 가끔 실패한다. 하네스는 구조화된 출력과 Pydantic 검증으로 받는다. 툴 호출이 5회를 넘으면 안 될 때 프롬프트로 횟수를 제한해도 모델이 무시할 수 있고, 하네스는 카운터를 두고 강제로 끝낸다. 하루 API 비용 한도나 입력 속 개인정보 마스킹은 아예 프롬프트로는 불가능하다고 적혀 있다.
하네스는 LLM이 '약속한 것'을 '강제'할 수 있습니다. (140쪽)
저자는 하네스를 두 관점으로 나눈다(36~37쪽). 에이전트를 쓰는 사람에게 하네스는 .md 파일에 적은 구조화된 텍스트에 높은 우선순위를 주는 일이고, 만드는 사람에게는 실행 코드에 제약 조건을 거는 일이다. 그리고 만드는 쪽 하네스가 맡는 일을 다섯 가지로 정리한다. 실행 흐름 제어, 가드레일, 입출력 검증, 상태 관리, 오류 복구.
이 구분으로 그동안 흐릿하던 게 정리됐다. 개발자 식으로 읽으면 코드 리뷰 코멘트와 CI 린트 규칙의 차이다. "이 함수는 이렇게 써주세요"라는 코멘트는 다음 PR에서 또 잊히지만, 린트에 걸면 빌드가 실패하니 잊을 수가 없다. CLAUDE.md에 적는 규칙은 코멘트 쪽이고, 이 책이 말하는 하네스는 린트 쪽이다. 규칙을 더 세게 적을 게 아니라 어느 쪽에 둘지부터 정해야 했던 셈이다.
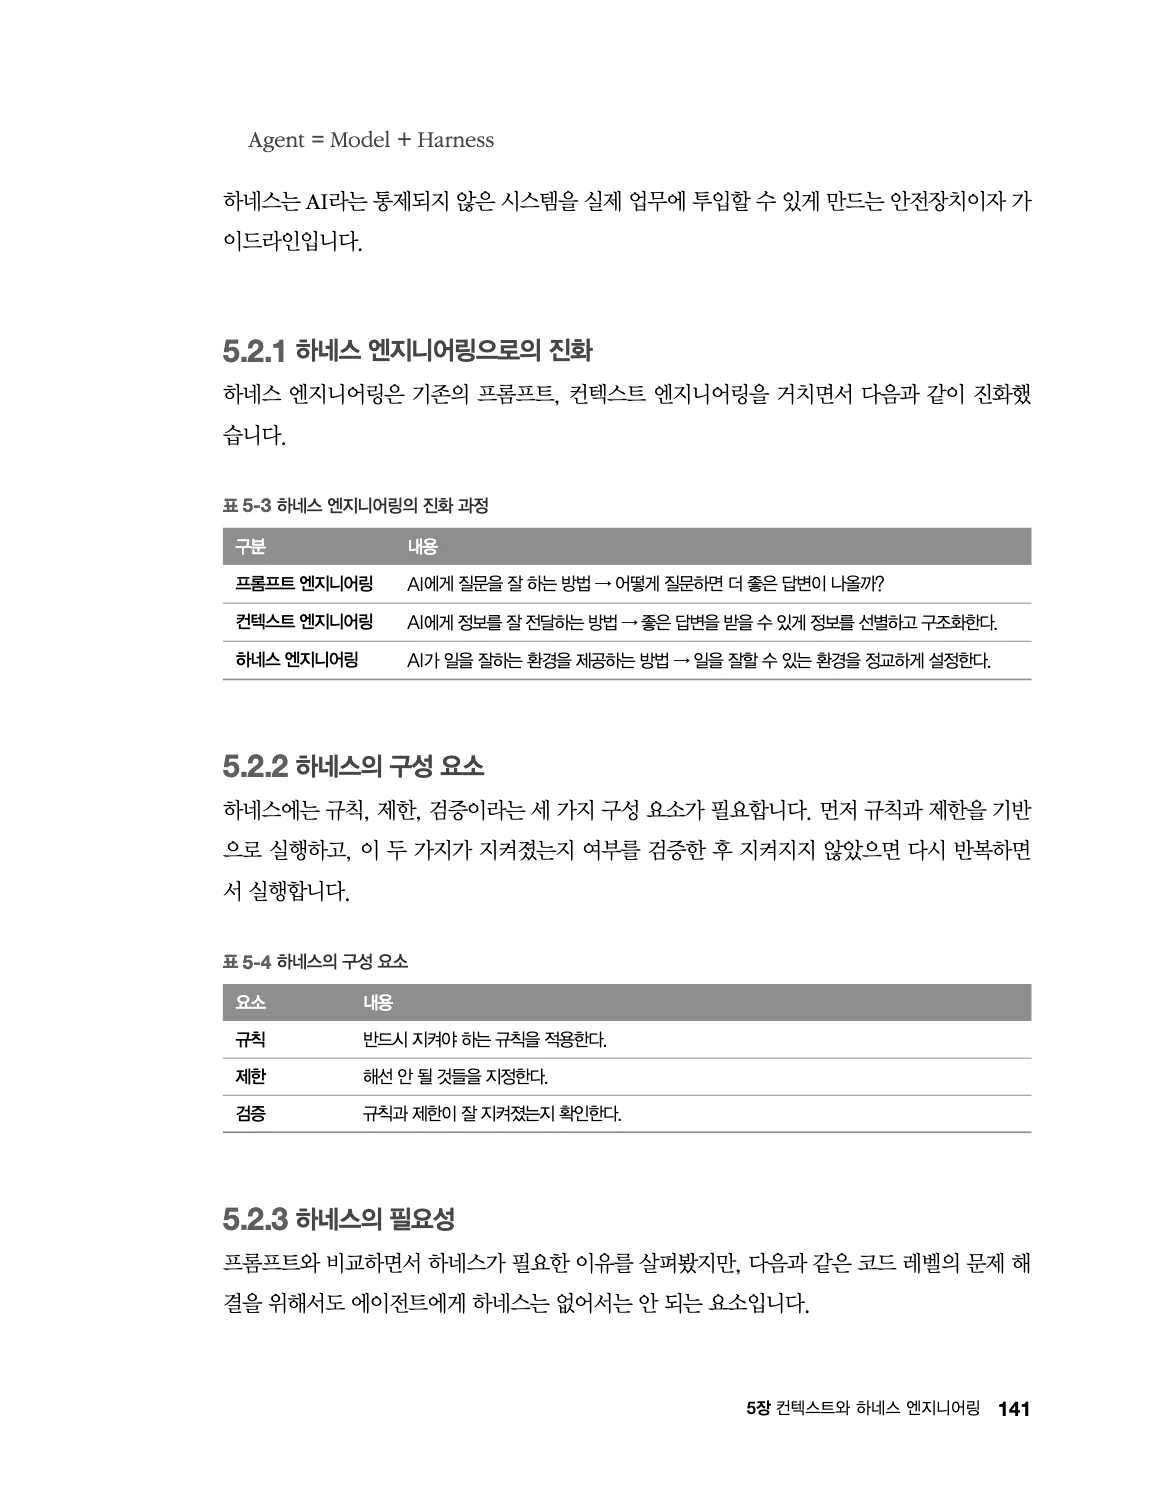
141쪽은 이것을 "Agent = Model + Harness"라는 식과 규칙, 제한, 검증 세 요소로 다시 줄인다. 142쪽에서는 하네스가 필요한 이유로 세션 간 기억 상실, 컨텍스트 열화, 자체 검증 실패를 든다. 마지막 항목이 특히 와닿았다. 에이전트에게 방금 한 일을 스스로 점검하게 하면 오류를 못 찾고 잘했다고 평가하기 쉽다는 것이다. 그래서 5장 후반의 구현은 입력 검증, 구조화된 출력, 가드레일처럼 모델의 자기 평가가 아니라 바깥의 코드가 결과를 확인하는 장치로 채워진다.
탈출 조건이 거의 모든 장에 나온다
장 제목에 하네스가 들어간 곳은 5장과 12장뿐이지만, 37~38쪽의 다섯 역할을 머릿속에 두고 읽으면 다른 장도 같은 이야기로 읽힌다.
3장 끝(93~95쪽)은 ReAct 루프의 탈출 조건을 네 가지로 정리한다. 최대 반복 횟수, 같은 툴을 같은 인자로 다시 부르는지 감지하기, 타임아웃, 토큰 한도. 각각의 약점도 표로 붙인다. 반복 횟수를 너무 낮추면 복잡한 질문에 답을 못 하고, 동일 호출 감지는 인자가 미묘하게 다르면 놓친다. 그래서 최대 반복 횟수와 타임아웃은 개발 버전에서도 반드시 켜두라고 한다. 8장(253쪽)에서는 같은 문제가 멀티 에이전트로 넘어가 에이전트끼리 서로 일을 떠넘기는 핑퐁 루프가 되고, 해법도 상태에 round_count를 두고 최대 라운드에서 끊는 것으로 같다.
10장의 자기수정 데이터 분석가는 이 패턴을 한 프로젝트에 모아둔 장이다. 생성한 코드를 실행 전에 AST로 분해해 파일 삭제, 시스템 명령, 외부 네트워크 호출이 보이면 사람 승인 게이트로 넘기고(304~305쪽), 실행 후에는 원칙 목록을 기준으로 데이터에 없는 수치를 지어내거나 상관을 인과로 단정한 답을 다시 돌려보낸다. 프롬프트로 "위험한 코드는 쓰지 마"라고 적는 대신 실행 경로 자체에 관문을 둔다는 점에서, 140쪽 표를 실제 코드로 옮긴 장이다.
12장은 허용 목록과 샌드박스 격리 단계가 좋았다
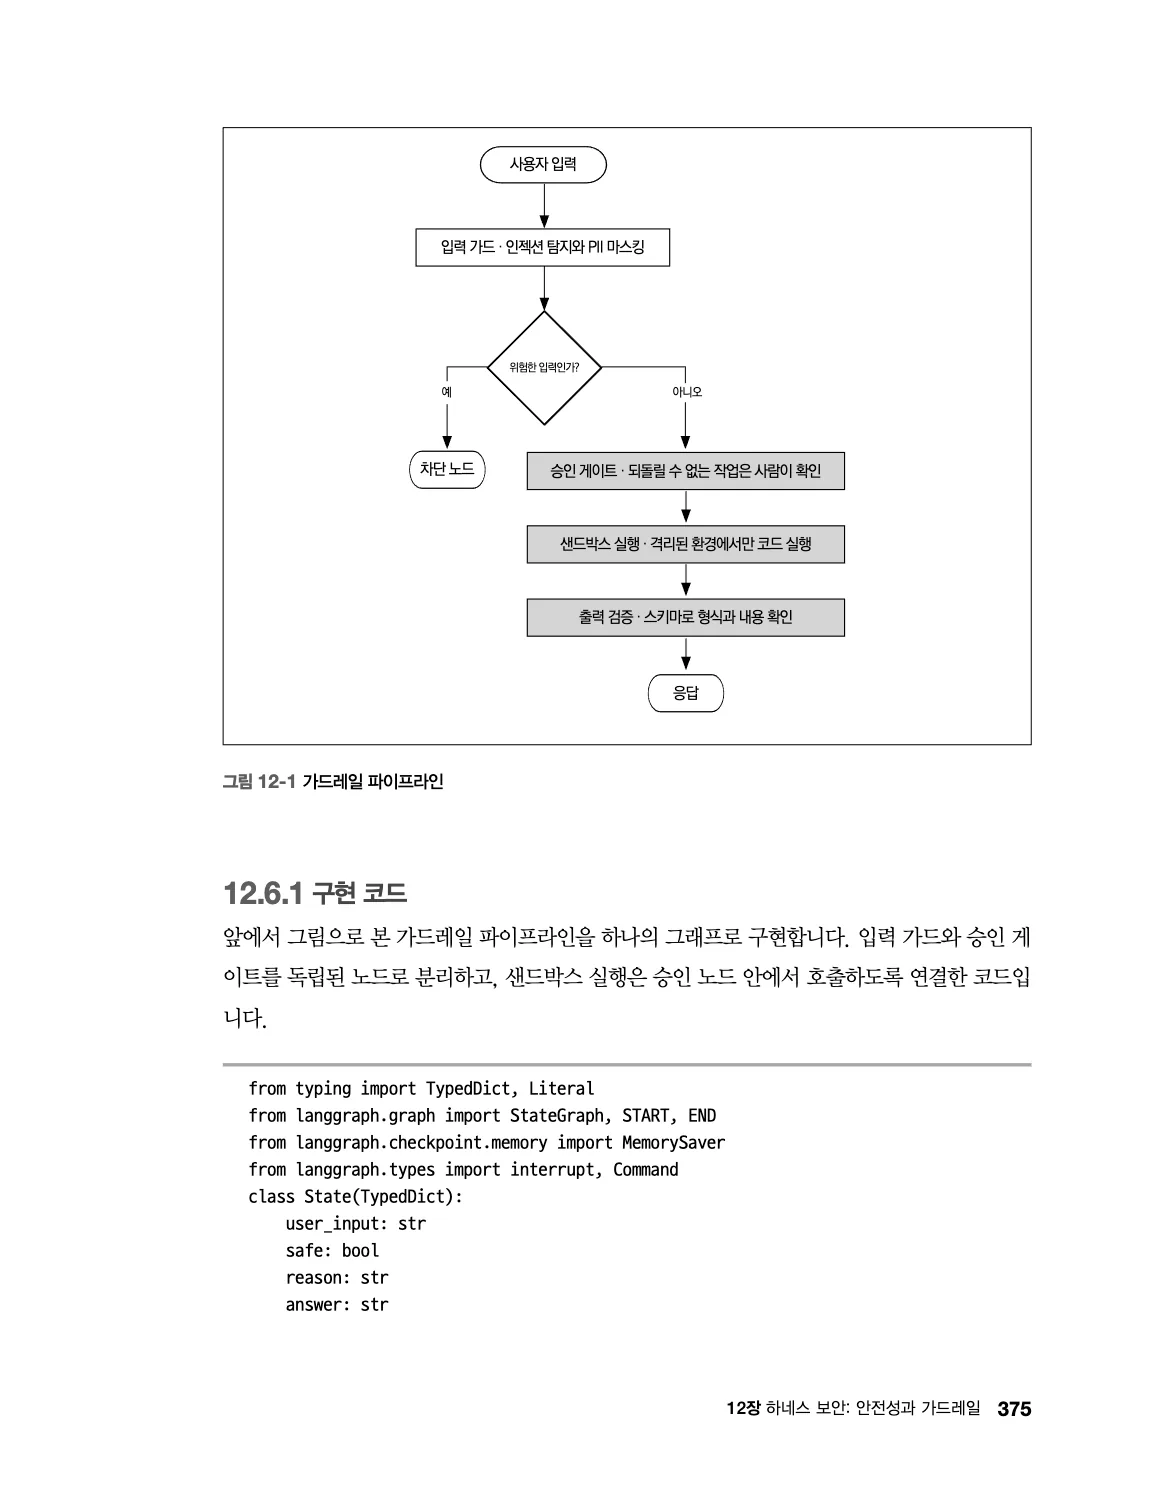
보안 장은 OWASP Top 10 for LLM을 뼈대로 삼는다. 툴은 차단 목록이 아니라 허용 목록으로 묶어야 새 툴이 추가돼도 기본값이 거부가 된다는 설명(367쪽), 그리고 AST 게이트는 문자열을 조합하거나 getattr로 우회한 호출을 잡지 못하니 1차 필터로만 쓰고 실제 실행은 샌드박스에서 하라는 단서(369쪽)가 붙어 있다. 정적 분석을 만능처럼 소개하지 않는다는 점이 믿음이 갔다.
371쪽은 코드를 가두는 방법을 프로세스, 컨테이너, gVisor, 마이크로 VM 네 단계로 나누고, 호스트 커널을 공유하는지를 기준으로 약한 것부터 강한 것까지 줄 세운다. 강할수록 안전하지만 무겁고 느려진다. 도커 기본 seccomp 프로파일이 막는 시스템콜이 생각보다 적다는 대목과 Claude Code가 리눅스에서는 Bubblewrap, macOS에서는 Seatbelt로 격리한다는 언급도 같은 면에 있다. 승인 게이트를 어디에 붙일지는 되돌릴 수 있는 행동인지로 정하라는 기준(370쪽)은 매번 승인 창을 누르다 지친 사람이라면 바로 써먹을 수 있다.
아쉬운 점
클로드 코드 절이 책 자신의 표 5-2와 어긋난다. 5.6절은 온라인에 유출된 것으로 알려진 시스템 프롬프트와 소스 추정 자료로 재구성했고 앤트로픽이 확인한 내용이 아니라고 미리 밝혀둔다(155쪽). 그런데 그 위에 쌓은 서술 일부가 공식 문서와 다르다. 160쪽은 CLAUDE.md가 매 턴 다시 주입되고, 작업과 무관한 규칙은 걸러지며, 모델에게 불변의 진리로 인식된다고 쓴다. 36쪽은 Claude Code가 모델의 명령과 출력을 가로채 지시 사항과 다르면 다시 검증한다고 쓴다. 공식 메모리 문서는 CLAUDE.md를 세션 시작 시 읽고 압축 뒤에 다시 읽어 넣는 컨텍스트로 설명하며, 강제되는 설정이 아니고 엄격한 준수를 보장하지 않는다고 적는다. 모델의 판단과 상관없이 어떤 행동을 막아야 한다면 PreToolUse 훅을 쓰라고 권한다. 즉 CLAUDE.md는 표 5-2의 프롬프트 열에 있고, 강제하는 쪽은 훅이다. 책의 표가 이 구조를 더 정확하게 설명하는데, 정작 클로드 코드를 다루는 절이 .md 파일에 강제력이 있는 것처럼 읽히게 써서 아쉬웠다. 출처가 불확실한 추정 자료보다 공개 문서를 근거로 삼았다면 더 단단했을 것이다.
검토 한도에 걸리면 'ok'가 된다. 10장의 자기검토 노드는 재작성 횟수가 한도에 닿으면 검토를 건너뛰고 verdict: "ok"를 돌려준다(306쪽). 비용이 끝없이 불어나지 않게 하려는 의도는 이해하고, 품질 검토를 보안 게이트처럼 멈춰 세울 필요도 없다. 다만 최종 verdict만 보면 검토를 통과한 답과 한도에 걸려 검토를 그만둔 답이 똑같이 'ok'이고, 한도에 걸렸다는 기록도 history에 새로 남지 않는다. 직전 검토 기록을 뒤져 맞춰 볼 수는 있지만, '검토 한도 초과'라는 판정을 따로 두었다면 10.8절의 평가 지표(재시도 횟수, 첫 시도 성공률)와도 바로 맞물렸을 것이다. 멈추지는 않더라도 조용히 통과시키지는 않는 편이 하네스답다.
하네스라는 실이 장 사이에서 끊겨 보인다. 전사본에서 '하네스'라는 단어를 세어 보면 1장, 5장, 12장에 몰려 있고 3장, 7장, 8장, 10장에는 한 번도 나오지 않는다. 내용으로는 3장의 탈출 조건, 7장의 휴먼 인 더 루프, 8장의 round_count, 10장의 AST 게이트가 전부 37~38쪽 다섯 역할의 구현이다. 12장에 와서야 10장의 분석 에이전트와 7장의 interrupt를 다시 불러와 보안 장치로 묶어 주는데(367, 369쪽), 앞 장들을 읽는 동안에는 그 연결이 보이지 않는다. 장마다 "이건 하네스의 어느 역할인가"를 한 줄씩만 달았어도 제목의 하네스가 책 전체를 꿰는 개념으로 읽혔을 것이다.
구성
지은이의 말과 이 책에 대하여로 시작해 4부 14장, 마치면서와 찾아보기로 닫는다. 본문은 413쪽까지다. 예제 코드는 깃허브 저장소에 있다.
- 1부 에이전트의 핵심 원리 (1~5장): 챗봇·RAG·에이전트 구분, 툴 호출 흐름과 MCP vs CLI, ReAct 루프와 탈출 조건, 단기·요약·벡터 DB 장기 메모리와 체크포인터, 그리고 컨텍스트 엔지니어링과 하네스 엔지니어링. 책의 개념 대부분이 이 부에 있다.
- 2부 에이전트 확장하기 (6~8장): 에이전틱 RAG와 그래프 RAG, 랭그래프 StateGraph와 조건부 라우팅·휴먼 인 더 루프·스트리밍, 슈퍼바이저·핸드오프·계층형 멀티 에이전트와 안전한 상태 관리.
- 3부 실전 프로젝트 (9~11장): 매일 아침 시장 브리핑을 보내는 선형 워크플로, 실패하면 스스로 코드를 고치는 데이터 분석가, PyBullet 시뮬레이션 속 VLM 집사 로봇. 프로젝트마다 시나리오, 성공·실패 기준, 구현, 평가 순서를 따른다.
- 4부 프로덕션과 운영 (12~14장): OWASP 기준 가드레일과 샌드박스 격리, vLLM으로 오픈소스 LLM 직접 서빙, FastAPI와 AWS Lambda 배포, 랭스미스 트레이싱과 비용 모니터링.
총평
하네스가 무엇인지 흐릿한 채로 폈는데, 덮고 나니 정의는 생각보다 단순했다. 모델이 약속한 것을 코드가 강제하는 것. 나머지 장들은 그 강제를 툴, 루프, 메모리, 멀티 에이전트, 보안, 배포 각각에 어떻게 거는지 보여주는 실습이다.
개발자로서 얻은 건 두 가지다. 하나는 하네스에 대한 선명한 정의고, 다른 하나는 CLAUDE.md를 다시 읽는 기준이다. 140쪽 표를 옆에 두면 어느 줄이 부탁으로 충분하고 어느 줄을 훅이나 코드로 옮겨야 하는지 가를 수 있다. 규칙을 더 세게 적는 것보다 규칙을 둘 자리를 바꾸는 쪽이 답일 때가 많다는 것도 이 책으로 정리됐다.
414쪽 마치면서에서 저자는 코드 작성은 AI에게 맡길 수 있어도 시스템을 책임지는 것은 결국 엔지니어라고 쓴다. 지은이의 말(5쪽)에서도 데모에서 잘 돌던 에이전트가 실제 환경에서 흔들릴 때 원인을 찾는 쪽은 상태와 흐름과 실패의 구조를 아는 엔지니어였다고 했다. 하네스라는 말이 유행어처럼 쓰이는 시기에, 그 말을 프롬프트 요령이 아니라 실행 경로 위의 코드로 되돌려 놓는 책이다.
#한빛미디어 #나는리뷰어다 #하네스엔지니어링